FDE Build Project · 미디어 · 콘텐츠

인터뷰 녹취에서 기사 초안까지,
발언은 그대로 둔 채

조선일보 스타트업 인터뷰 칼럼 "쫌아는기자들"을 위한 기사 자동화 에이전트 ScribeClaw. 인터뷰 녹취를 올리면 기자 톤의 기사 초안까지 만들어 주되, 핵심은 속도가 아니라 "인터뷰이의 말을 바꾸지 않는다"는 신뢰를 시스템 구조로 보장하는 것입니다.

🏢 조선일보 · "쫌아는기자들" 👥 성호철 차장 (인터뷰 칼럼) 🧪 dev PoC 실사용 (1인)
발언 그대로모든 인용을 원문과 대조(VERBATIM)
되묻기애매한 숫자·날짜는 자동 수정 금지
녹취 → 초안업로드 한 번에 기사 초안까지
7중 계약인용 정확성을 구조로 보장 (L1~L7)
The Challenge

저널리즘에선, 빠른 것보다 틀리지 않는 것

일반 전사·요약 도구는 발언을 "그럴듯하게" 다듬다 실제 말이 바뀝니다. 기사에서는 이것이 치명적입니다.

1

자동화 도구가 발언을 바꾼다

일반 도구는 인용을 매끄럽게 다듬다 실제 발언을 바꾸고, 애매한 부분을 임의 추측으로 채웁니다. 인터뷰이의 말을 왜곡하면 안 되는 저널리즘에는 쓸 수 없었습니다.

2

수작업 병목

60분 인터뷰 기준 녹취 풀어쓰기 1~2시간, 초안 작성 1~3시간. 게다가 인용 하나하나를 원문과 대조하는 일까지 사람이 수동으로 했습니다.

3

받아쓰기가 고유명사·숫자를 흔든다

회사명·제품명·투자금·날짜를 잘못 알아들으면 곧 기사 오류입니다. 특히 숫자는 "틀린 숫자도 그럴듯한 숫자"라 텍스트만으로는 옳고 그름을 알 수 없습니다.

The Solution

추측하지 않고, 대조하고, 되묻는다

녹취 업로드 → 회사 사전 → 전사 → 선별 정정 → 각도 선정 → 기사 초안. 창을 닫아도 서버에서 계속 진행되고, 판단이 필요한 순간엔 기자에게 넘깁니다.

STEP 1

회사 사전

보도자료·IR로 고유명사를 미리 등록.

STEP 2

전사(받아쓰기)

녹취를 화자별로 받아쓰기.

STEP 3

선별 정정

애매한 건만 기자가 확인.

STEP 4

각도 선정

기사 각도와 구조를 잡음.

STEP 5

초안 + 검증

인용을 원문과 대조한 초안.

기능 ① · 준비

회사 사전으로 받아쓰기 정확도를 미리 올린다

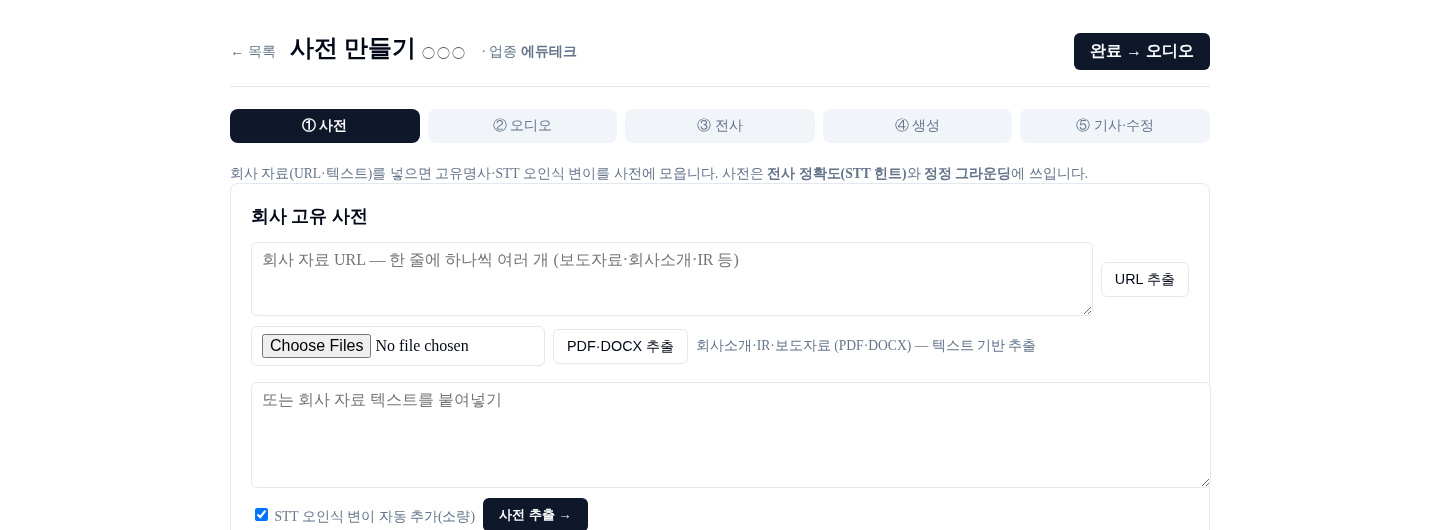
인터뷰 전에 회사의 보도자료·IR(링크·PDF·텍스트)을 넣으면, 고유명사와 받아쓰기가 흔들리기 쉬운 표현을 미리 수집해 전사·정정의 근거로 씁니다.

  • 회사명·제품명·투자금 같은 고유명사를 사전에 등록
  • 받아쓰기 오인식 후보를 미리 확보해 오류를 줄임
회사 사전 만들기 화면 — 보도자료·IR에서 고유명사 수집 (회사명 마스킹)
회사 사전 만들기 (인터뷰이 회사명은 마스킹)
기능 ② · 되묻기

애매하면 추측하지 않고 기자에게 되묻는다

명백한 받아쓰기 오류는 자동 교정하지만, 애매하거나 숫자·날짜는 절대 자동 수정하지 않고 기자에게 확인을 요청합니다. 해당 구간의 원음과 앞뒤 맥락을 함께 보여줘, 기자는 채택·원문 유지·보류만 고르면 됩니다.

  • 숫자·날짜 자동 수정 금지 — 틀린 오류가 조용히 들어가지 않음
  • 원음 재생 + 앞뒤 맥락으로 빠른 판단
  • 기자는 사후 검수자가 아니라 작성 과정의 결정권자
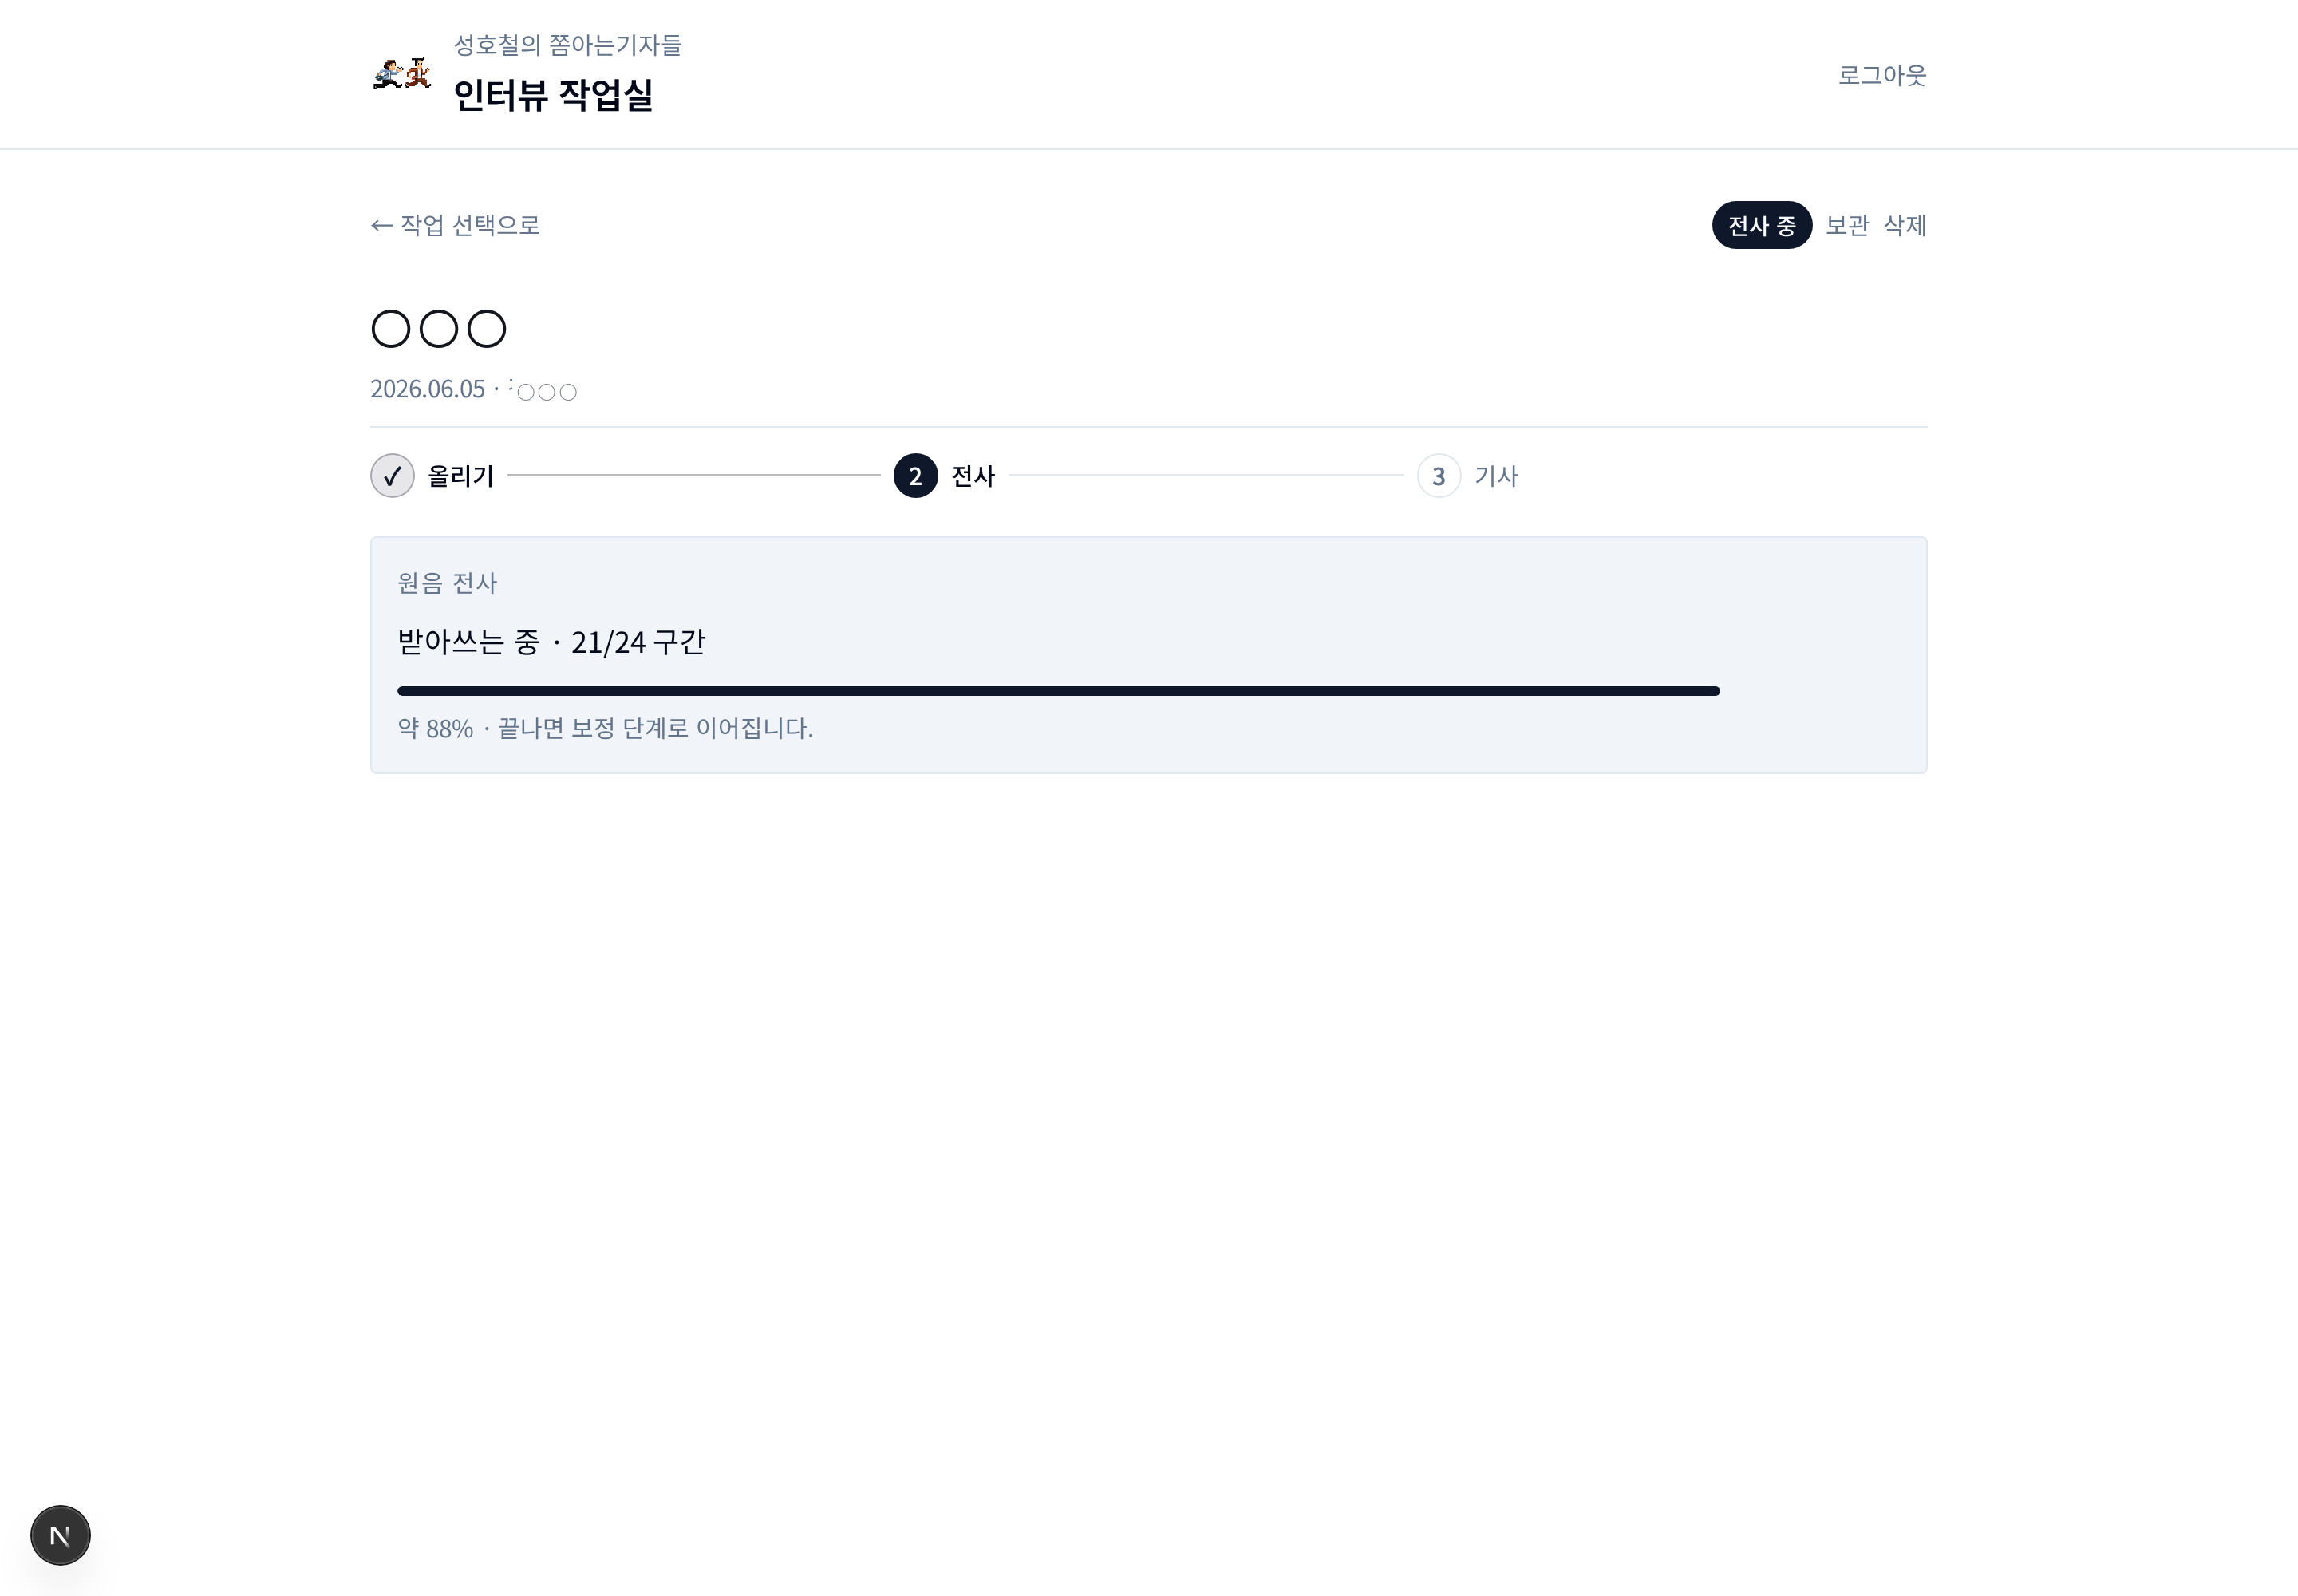
전사 진행 화면 — 화자별 받아쓰기 (회사명·기자명 마스킹)
전사(받아쓰기) 진행 (회사명·기자명은 마스킹)
기능 ③ · 핵심 차별점

자기가 쓴 인용을 원문과 대조하고, 틀리면 스스로 고쳐 쓴다

초안의 모든 인용을 원문과 한 건씩 대조하고, 어긋난 문단만 다시 써서 재검증하는 과정을 스스로 반복합니다. 근거 없는 서술(지어낸 사실)도 감지해 표시합니다.

  • 모든 인용을 원문과 대조 → 어긋난 곳만 재작성 → 다시 검증
  • 출처 없는 서술을 감지해 표시
  • 모든 수정에 누가·무엇을·왜 기록이 남아 추적·복원 가능
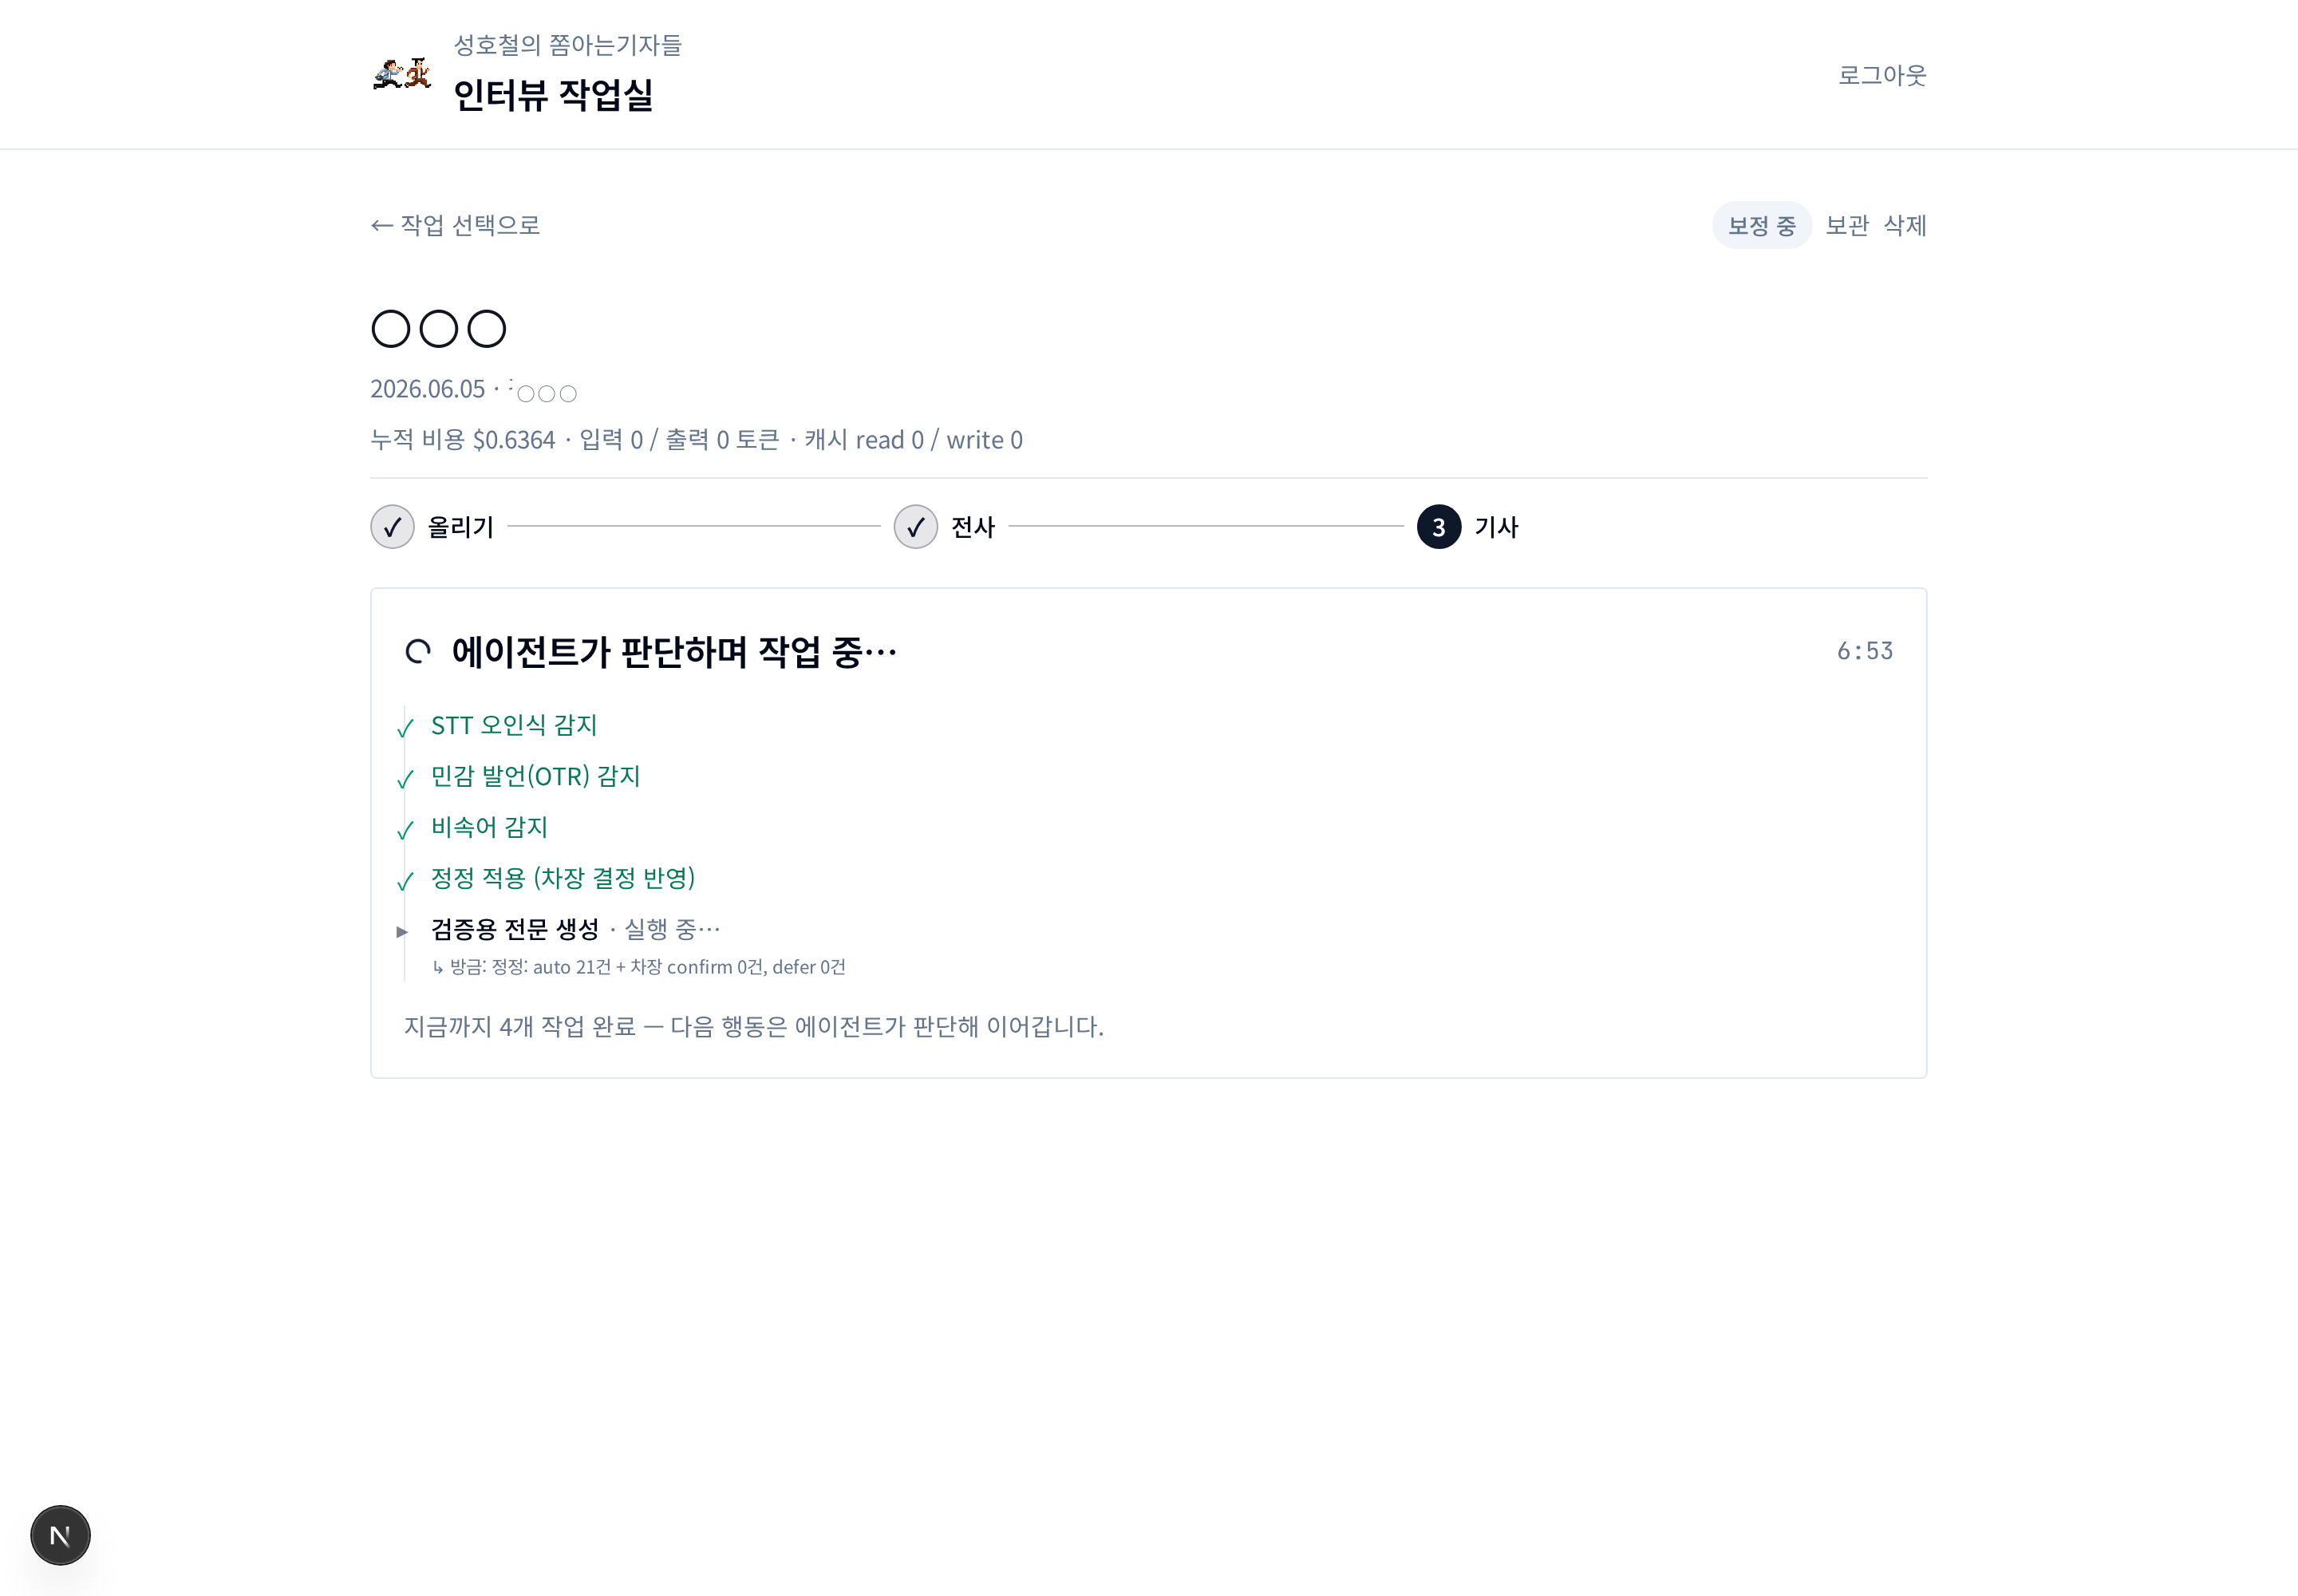
에이전트 자율 검증 진행 — 오인식·민감발언 감지 → 정정 → 검증용 전문 생성 (회사명 마스킹)
에이전트가 감지 → 정정 → 검증까지 스스로 판단
기능 ④ · 관리

인터뷰별로 진행 상태와 비용을 한눈에

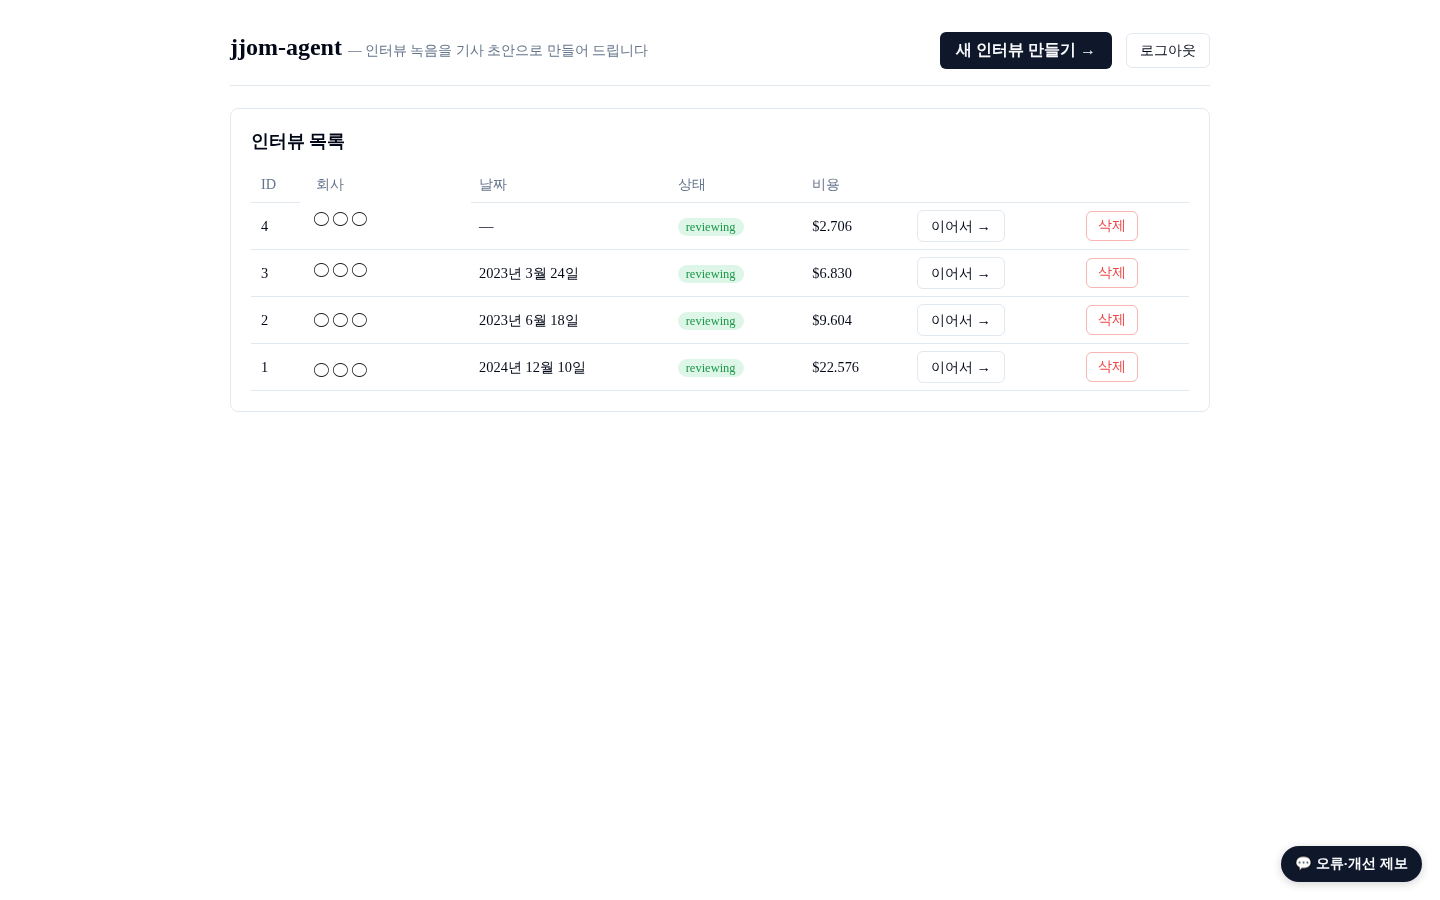
인터뷰마다 진행 상태와 생성 비용을 대시보드에서 확인하고, 언제든 이어서 작업할 수 있습니다. 각도(angle)를 먼저 잡고 인터뷰 시간 순서가 아니라 "기사"로 재구성합니다.

  • 인터뷰별 상태·건당 비용을 투명하게 표시
  • 기자의 과거 기사 톤·용어에 맞춰 초안 작성
  • 중단해도 이어서 — 작성 맥락이 서버에 보존
인터뷰 대시보드 — 건별 상태와 생성 비용 (회사명 마스킹)
인터뷰 대시보드 · 건별 비용 (회사명은 마스킹)
“인용 정확성을 사람의 주의력이 아니라 시스템 구조로 보장한다.”

숫자 자동 수정 금지, 인용 원문 검증 같은 규칙을 코드 계약(L1~L7)으로 못 박아, 발언 왜곡이 애초에 들어갈 수 없게 설계했습니다.

The Impact

속도가 아니라, 신뢰를 자동화하다

1인 운영 PoC 단계로, 운영 성과 지표(발행 편수·만족도)는 아직 없습니다. 지금까지 확인된 것은 다음과 같습니다.

BEFORE
  • 녹취 풀어쓰기 1~2시간 + 초안 작성 1~3시간
  • 인용을 하나하나 원문과 수동 대조
  • 받아쓰기가 고유명사·숫자를 바꿀 위험
AFTER
  • 녹취 업로드 → 기자 톤 초안 자동 생성
  • 모든 인용을 원문과 자동 대조·재작성
  • 숫자·날짜는 자동 수정 금지, 애매하면 기자에게 확인
신뢰 설계
7중 계약

인용 원문 검증, 숫자 자동수정 금지 등 저널리즘 원칙을 코드 계약(L1~L7)으로 강제해, 발언 왜곡이 구조적으로 들어갈 수 없게 만들었습니다.

현황

조선일보 차장이 dev에서 실사용 중

게이트-루프·기자 확인(HITL)·작업 맥락 영속화가 동작하며, 실제 인터뷰 여러 건을 처음부터 끝까지 처리해 초안을 생성했습니다(건당 약 $2.7~$22.6). 팩트 교차검증 강화와 정식 운영을 준비하고 있습니다.

Tech Stack

검증된 스택 위에

기자가 자리를 비워도 맥락을 잃지 않는 사람-참여(HITL) 런타임과, 인용을 원문과 대조하는 검증 루프가 핵심입니다.

Django · DRF LangGraph (HITL · 체크포인터) OpenAI GPT (기사 생성) Claude Sonnet (개요·노트) Gemini 2.5 Flash (전사·화자분리) standarda-core LangSmith 트레이싱 Vanilla HTML/CSS/JS